A NVIDIA apresentou o Nemotron 3.5 Lightning, um modelo de código aberto direcionado para cargas de trabalho de inteligência artificial agéntica, acompanhado pela biblioteca NeMo Switchyard. A novidade, detalhada no blog oficial da empresa, baseia-se num princípio pragmático: agentes autónomos que operam durante longos períodos não precisam de recorrer constantemente a modelos de raciocínio massivos para operações de rotina. Responder a consultas, verificar resultados ou delegar processos são tarefas que podem ser resolvidas de forma rápida, exigindo muito menos recursos das placas gráficas RTX.
Alta velocidade com baixo custo computacional
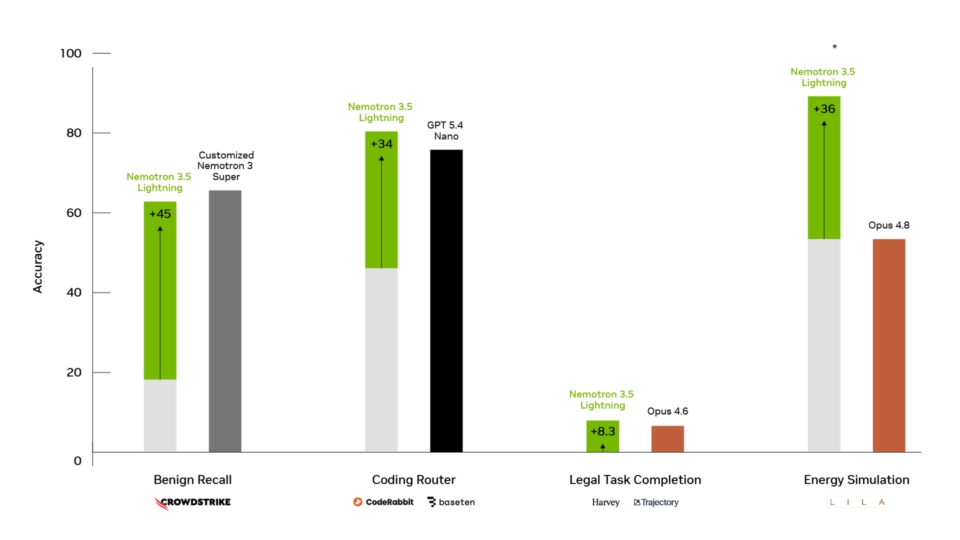
O novo modelo baseia-se na arquitetura Mixture-of-Experts, contando com um total de 30 mil milhões de parâmetros. No entanto, o sistema ativa apenas 3 mil milhões de parâmetros durante o processamento de cada token. Esta configuração híbrida conserva uma forte capacidade de resolução sem assumir a despesa computacional contínua de uma rede massiva. Segundo a fabricante, a velocidade de geração chega a ser 4 vezes superior à de ofertas abertas equivalentes. No teste PinchBench, a plataforma registou 86% de precisão e completou 10.000 tarefas com uma rapidez 30% superior ao modelo Qwen3.6 35B.
Para garantir esta cadência técnica, a marca adotou táticas como a predição de múltiplos tokens e a descodificação especulativa. O Nemotron 3.5 Lightning é distribuído nos formatos BF16 e NVFP4, consistindo este último numa quantização de 4 bits focada na redução drástica dos requisitos de memória e aceleração da inferência. O suporte de hardware abrange desde servidores corporativos com chips Hopper e Ampere até computadores locais munidos de uma GeForce RTX 5090. Ferramentas consolidadas na comunidade de desenvolvimento local, como o LM Studio e o Ollama, já permitem correr o novo ficheiro de pesos de forma nativa.
Delegação inteligente de processos
Em sintonia com o novo LLM aberto, a NVIDIA disponibilizou o NeMo Switchyard, uma ferramenta focada exclusivamente no reencaminhamento de pedidos. O sistema analisa cada interação de forma autónoma e escolhe a rede de IA mais adequada para a tarefa, equilibrando a latência, o custo e o nível de raciocínio necessário. Um programador ganha assim a liberdade de integrar em simultâneo os modelos GPT, Claude e Nemotron, garantindo que o seu projeto delega dinamicamente a carga de trabalho.
Uma avaliação levada a cabo com a LangChain demonstrou o impacto prático desta divisão em 145 tarefas agénticas multiturno. O Switchyard atribuiu apenas 7% das chamadas complexas ao Claude Opus 4.8, empurrando as restantes operações para o Nemotron 3.5 Lightning. Esta gestão originou uma poupança financeira de 74%, sofrendo uma queda marginal de 6 pontos na precisão. Outras parceiras confirmaram resultados paralelos: a Ramp diminuiu os custos operacionais em 58% e cortou o tempo de resposta em 33%, ao passo que a Classmethod poupou 27% mantendo a qualidade nas suas primeiras provas.
Para o mercado tecnológico europeu e nacional, onde o custo de operação de infraestruturas locais face a faturas de serviços externos é um tema crítico diário, esta arquitetura mista abre a porta à democratização de agentes inteligentes. O cenário das tarefas perpétuas torna-se financeiramente exequível quando a maioria das reações rotineiras flui de forma local dentro do equipamento do utilizador, libertando a nuvem apenas para as dúvidas estruturais de alto nível.


Nenhum comentário
Seja o primeiro!